fbpx Mappa INGV | Page 121 | Scienza in rete

Mappa INGV

Primary tabs

Read time: 1 min

Aggiornamento dati del 21/05/ 2012

La sequenza sismica di Modena-Ferrara in queste ultime ore ha continuato a manifestarsi con molte decine di repliche. In totale, al momento (le 8 del 21/5) ne sono state localizzate oltre 170. Dall’inizio della sequenza, gli eventi di magnitudo superiore a 5 sono stati 2; quelli con magnitudo tra 4 e 5 sono stati in totale 8; 37 di magnitudo compresa tra 3 e 4. L’ultimo evento di magnitudo superiore a 3 è avvenuto alle 4:35 (ora italiana).Nelle ultime ore abbiamo osservato molte repliche di bassa magnitudo, anche a causa del miglioramento della rete sismica ottenuto con alcuni sismometri installati ieri in area epicentrale, che hanno contribuito ad abbassare la soglia di localizzazione.
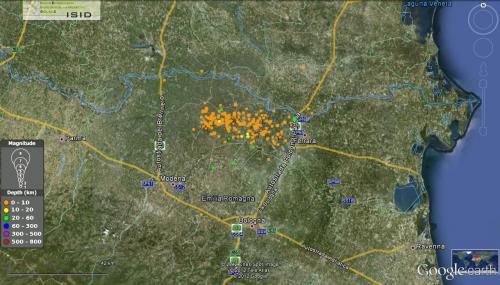
Mappa epicentrale aggiornata alle 8 del 21 maggio 2012. Le stelle indicano i terremoti di magnitudo maggiore di 4. L’intera struttura delineata dalle repliche si estende per quasi 40 km in senso est-ovest tra la bassa modenese e la periferia ovest di Ferrara.

Fonte: Comunicato INGV
Autori: 
Sezioni: 
Indice: 
Terremoto Emilia

prossimo articolo

LLM e ricerca scientifica: opportunità, rischi e controlli

disegno di ricercatore al computer

Come integrare i modelli linguistici di grandi dimensioni nel processo scientifico senza comprometterne l'integrità? Gli LLM sono utili quando velocizzano lavoro ripetitivo e preparatorio. Diventano rischiosi quando il loro output entra direttamente nel processo di validazione o nella decisione scientifica. La questione da porre non è se ma come integrarli nel processo scientifico senza comprometterne l'integrità.

Immagine di copertina realizzata con ChatGPT

Nel discorso pubblico, intelligenza artificiale e Large Language Model (LLM) vengono spesso usati come sinonimi. Non lo sono. L'IA è il campo più ampio che comprende tecniche diverse — dai sistemi simbolici all'apprendimento automatico, dalla visione artificiale alla robotica, fino ai modelli generativi. Gli LLM sono una classe specifica di questi sistemi: modelli addestrati su grandi quantità di testo e, sempre più spesso, di dati multimodali, capaci di produrre risposte linguisticamente plausibili, codice, sintesi, classificazioni e proposte operative.